







 (1).jpg)

コンテキストデータの整備は“仕組み”に尽きる
組織の再設計とともに進めなければならないのが、部門やシステムをまたぐデータを意味や関係性、時間的な経緯まで含めてAIが扱える状態にした「コンテキストデータ」の整備です。AIがコンテキストデータを読み解くことで、人だけでは気づけなかった視点まで拾い上げ、提案してくれるようになります。
では、AIが横断的・網羅的に把握できるコンテキストデータをどのように生み出すのか。まずは土台となる仕組み作りが大きな壁となります。
おそらく多くの企業の課題は、「既存の社内システムをどう入れ替えるか」「データ統合をどう進めるか」でしょう。「セントラル型」で1つのシステムにすべてを統合しようとするケースも多いですが、業務特化型のSaaSを複数導入しているほど難易度は上がります。また、統合に工数や人手をかける場合、リソースの関係から扱うデータを取捨選択しなければならなくなります。結果的に、実は必要なデータまで切り捨ててしまうリスクも考えられます。
実際には、既存システムをまるごと刷新する必要はないのです。当社は、複数のシステムをつないで1つの大きなプラットフォームにする「ハブ型」のほうが負担は少なく、かつ速いスピードでAIに対応できると考えています。将来的なリプレイスにともなう負担も抑えやすく、移行による煩雑化も避けられます。
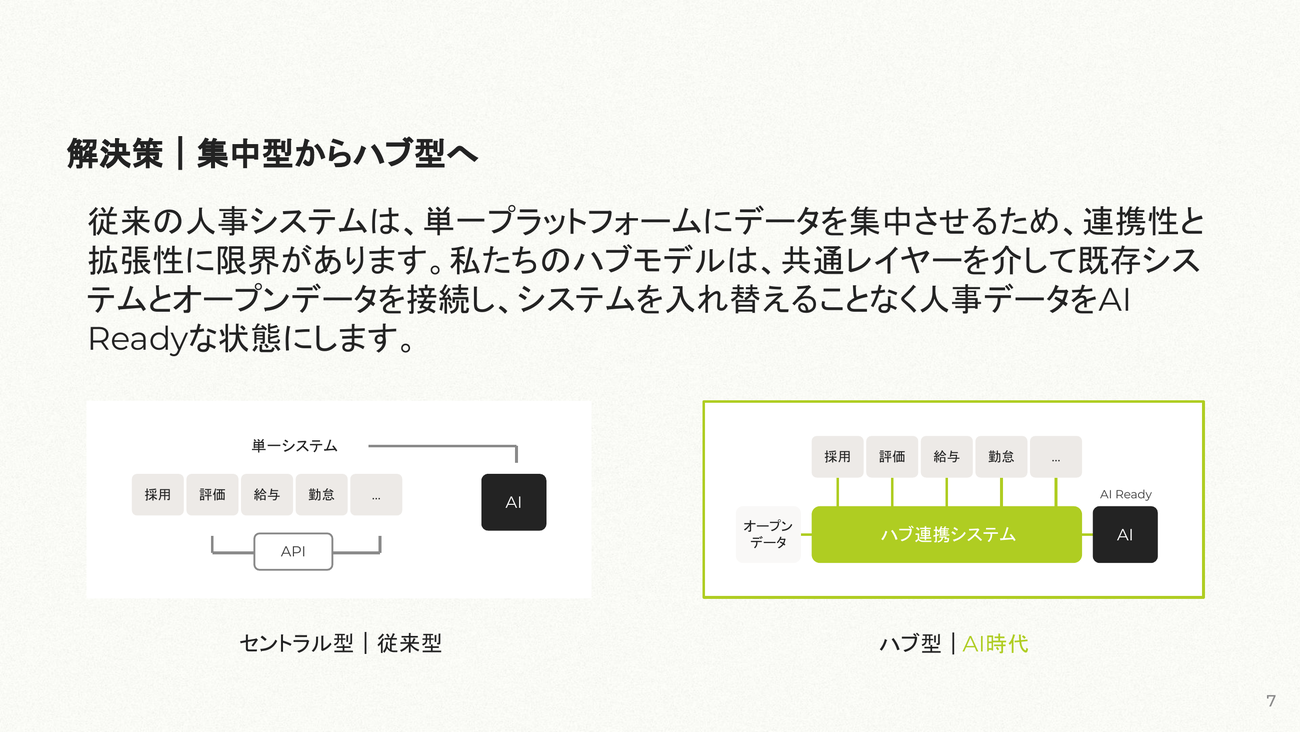
理想は、半自動でリアルタイムにコンテキストデータが生成される状態です。必要なデータがその都度選ばれ、AIが把握し、アウトプットを返す。たとえば当社の場合は、データ構造を自動でマッピングする技術や多次元のデータ構造を扱う技術を開発しています。ここまで仕組みを作り込まなければ、リソースとコストの壁にぶつかり、途中でプロジェクトが頓挫することもあります。
もう一つ、属人的な更新作業も解消すべき課題です。新しい情報が管理データに反映されず、わざわざ人手で更新しなければならないことも少なくありません。こうした構造はあちこちで見られます。しかし、これも情報が生まれる源泉とそれを管理するシステムを自動でつなげば解決します。ハブ型の考え方そのものです。
最大の難所ともいえるのはデータ構造。サイロ化した複数のデータ同士を「同じカテゴリーで同じ意味を持ち、互いに関係している」と認識させてつなぎ合わせることは、難易度が高いです。この壁を乗り越える手段として、たとえば当社はAIの目的に応じたコンテキストデータを生成する「XD Foundry」といった技術を保有しています。今後は、こうしたコンテキストレイヤーを担うサービスが次々に登場するでしょう。