








AI Librariumは2026年10月23日、情報処理学会 コンピュータセキュリティ研究会が主催する「コンピュータセキュリティシンポジウム2026(CSS2026)」で、東北大学の研究者らとの共著論文「個人識別情報保護に向けた正規表現ルールとローカルLLMによる軽量な事前検出手法」を発表した。この手法は、社内文書を生成AIなどの外部サービスへ送る前に、氏名・住所・メールアドレスなどの個人識別情報(PII)を社内環境だけで検出・マスキングするものである。日本語500文書を用いた評価では、検出精度(Relaxed F1)がLLMを使わない構成の0.672から0.790へ改善した。速度は、文書全体をLLMで処理する方式の約3.2倍だった。
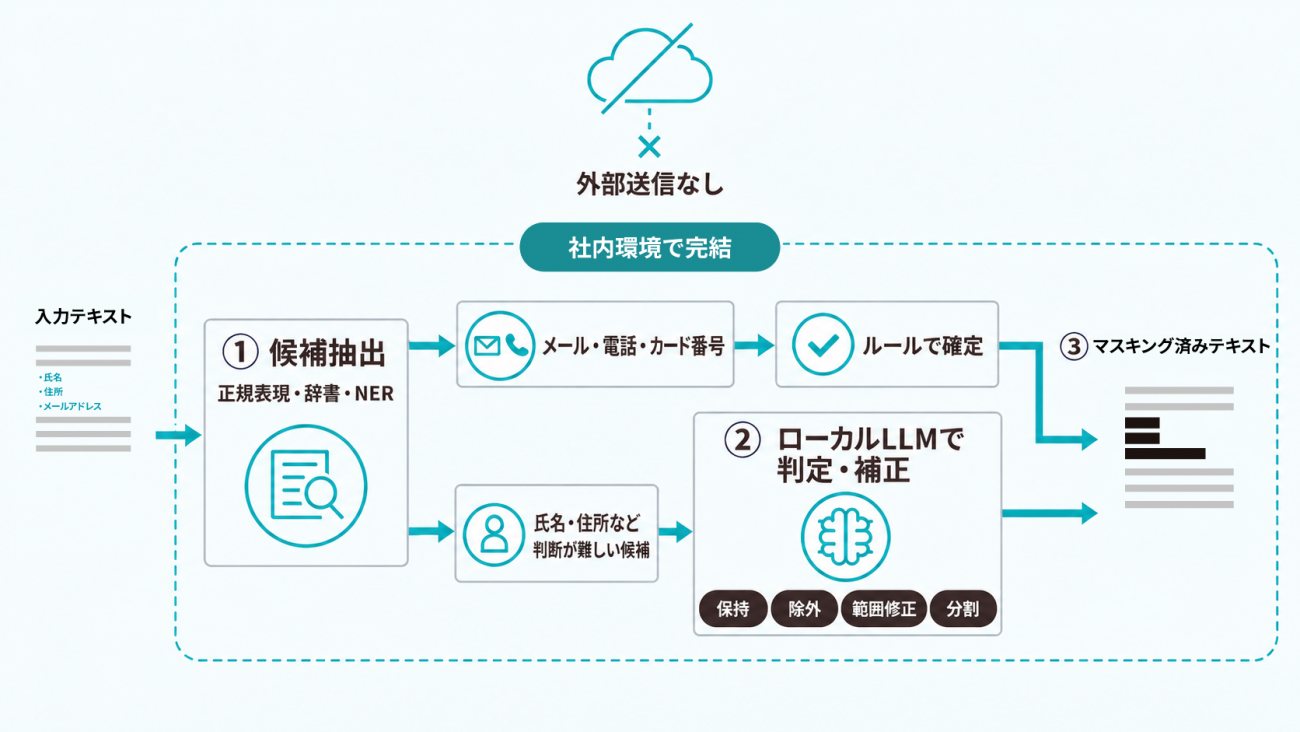
手法は二段階で構成される。第一段階では、正規表現、都道府県名や一般的な日本人の姓などを収めた固定辞書、日本語の固有表現抽出(GiNZA)を組み合わせて候補を洗い出す。形式が明確なメールアドレス・電話番号・クレジットカード番号は、この段階でLLMを通さずに確定する。第二段階では、氏名・住所など判断が難しい候補に限り、ローカル環境で動くLLM(gpt-oss:20b)が「保持」「除外」「範囲の修正」「分割」のいずれかを判定する。LLMの呼び出しは1文書につき最大1回で、判断は候補の内側に限られるため、処理時間を抑えられる。@の左側に日本語を含むメールアドレスは、候補を広めに取り、LLMが文脈から正しい範囲を切り出す。すべての処理は社内のPC・サーバー上で完結する。
評価には、公開データセット「OpenPII 1.5M」の日本語文書のうち、手法の開発に使っていない500文書を用いた。1文書あたりの平均処理時間は、提案手法が11.97秒、LLMなし構成が0.026秒、文書全体をLLMで処理する方式が38.76秒だった。文書全体をLLMで処理する方式の検出精度は0.625である。LLMなし構成と比べ、メールアドレスの検出精度は0.558から0.971へ、氏名は0.581から0.745へ向上した。500文書中74文書(14.8%)は、LLMを一度も呼び出さずに処理を終えた。計測はGPUにNVIDIA GeForce RTX 4060 8GB、メモリ16GBを搭載したPCで行った。
一方、住所・電話番号では、LLMなし構成との明確な差は確認されなかった。同社は今後、候補抽出の網羅性の向上、年齢や運転免許証番号などへの検出対象の拡張、実際の業務文書での検証を進める。研究成果は、企業向けAIガバナンス支援サービス「AIL Governance X」などに活かすとしている。
【関連記事】
・90%が過去1年間にエージェンティックAIセキュリティのインシデントを経験/ServiceNow調査
・富士通、金融機関向け専有型AIプラットフォームの開発へ データ主権・セキュリティを担保
・日立、OpenAIとの連携を本格化 両社のFDE連携でAX支援・サイバーセキュリティ強化へ
- 関連リンク
この記事は参考になりましたか?
- この記事の著者
-

AIdiver編集部(エーアイダイバーヘンシュウブ)
「AIdiver」(エーアイダイバー)は、株式会社翔泳社が運営する、企業およびビジネスパーソンのAIの利活用にフォーカスしたメディアです。経営、ビジネス、日々の業務をAIで変革したい「AIリーダー」の皆さまに役立つコンテンツを発信します。
※プロフィールは、執筆時点、または直近の記事の寄稿時点での内容です
この記事は参考になりましたか?
この記事をシェア